Filtry w sklepie internetowym a SEO: nawigacja fasetowa, indeksacja i podkategorie
Spis treści ▾
W skrócie
- Filtr kontra podkategoria: filtr to adres z parametrami bez własnej treści i intencji; podkategorię dodaje się w panelu sklepu w kilka minut, a filtry indeksowalne to zwykle zmiana w kodzie platformy.
- Wybór kombinacji: sprawdź popyt w Search Console i w Ahrefs lub Planerze, policz produkty, obejrzyj SERP i zadbaj, by podkategoria nie kanibalizowała kategorii nadrzędnej.
- Co robi robots.txt: zarządza ruchem robota, nie indeksem, więc nie usuwa adresów z wyników.
- Noindex: działa tylko wtedy, gdy strona nie jest jednocześnie zablokowana w robots.txt, a ponowna wizyta robota może potrwać nawet miesiące.
- Mój wniosek z dokumentacji: filtry, których nie ma jeszcze w indeksie, blokuję w robots.txt; gdy już w nim są, najpierw dodaję noindex i dopiero potem ewentualnie blokuję crawlowanie.
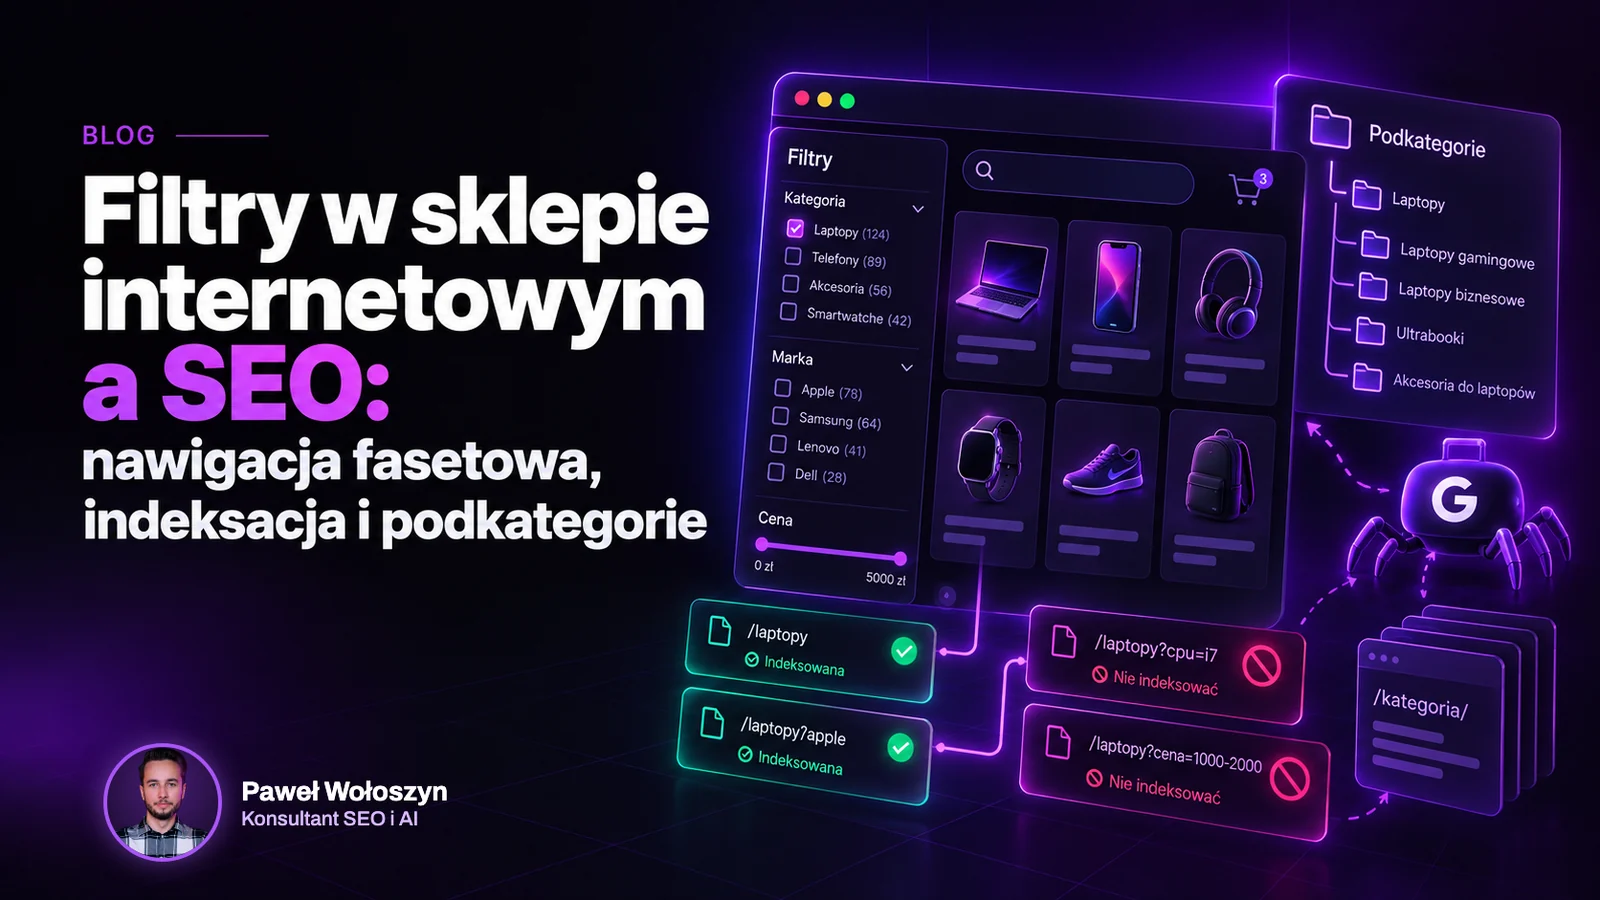
Filtry (nawigacja fasetowa) mają pomagać klientowi zawęzić listę produktów, a nie tworzyć strony pod pozycjonowanie. Najczęściej działają na parametrach adresu URL i nie powinny być indeksowane. SEO robi się na podkategoriach: statycznych stronach z własnym adresem, tytułem, nagłówkiem H1 i opisem pod frazy, na które ludzie naprawdę szukają. To tańsze i pewniejsze niż programowanie indeksowalnych filtrów od zera.
Dlaczego filtry nie powinny trafiać do indeksu?
Bo każda kombinacja filtrów to nowy adres, a kombinacji są tysiące. Google opisuje to wprost: najczęstsza implementacja nawigacji fasetowej, oparta na parametrach URL, może generować nieskończone przestrzenie adresów. Skutki to nadmierne crawlowanie (robot odwiedza ogromną liczbę adresów, zanim uzna je za bezużyteczne) i wolniejsze odkrywanie nowych, wartościowych stron (Google: Managing crawling of faceted navigation URLs).
W typowym sklepie adres /buty?kolor=czarny&rozmiar=42&marka=x pokazuje kilka produktów z kategorii, którą Google już zna. Nie ma własnej treści, własnego tytułu ani własnej intencji. Pomoc Search Console podaje warianty strony z zastosowanymi filtrami jako przykład stron, których nie ma sensu indeksować, zwłaszcza gdy pokazują tę samą kolekcję, tylko przefiltrowaną lub posortowaną (Page indexing report). O tym, jak takie adresy zamieniają się w duplikaty i które z nich Google wybiera jako kanoniczne, piszę w osobnym wpisie o duplikacji opisów produktów.
Co zamiast indeksowanych filtrów: podkategorie
Podkategoria to zwykła, statyczna strona listingu: własny, czytelny adres (np. /buty-biegowe/damskie/), unikalny tytuł, H1 i krótki opis, a do tego miejsce w menu i w linkowaniu wewnętrznym. Dlaczego to lepsze niż zaindeksowanie filtrów? Żeby filtr zachowywał się jak strona pod SEO, trzeba zaprogramować wszystko, co podkategoria ma domyślnie:
- własny, stabilny adres dla wybranych kombinacji,
- tytuł, H1 i opis generowane osobno dla każdej z nich,
- linki prowadzące do tej strony,
- wpis w mapie strony (sitemap),
- poprawne kanoniki,
- wyjątki w blokadach, które obejmują pozostałe, niechciane kombinacje.
Podkategorię dodaje się w panelu sklepu w kilka minut i można ją ręcznie dopracować, a filtry indeksowalne to zwykle zmiana w kodzie platformy. Dla większości sklepów to zbędny koszt.
- Filtr (nawigacja fasetowa)Adres z parametrami, np. /buty?kolor=czarny&rozmiar=42&marka=x. Pokazuje kilka produktów z kategorii, którą Google już zna. Nie ma własnej treści, tytułu ani intencji. Nie powinien być indeksowany.
- PodkategoriaStatyczna strona listingu: własny, czytelny adres (np. /buty-biegowe/damskie/), unikalny tytuł, H1 i krótki opis, miejsce w menu i w linkowaniu wewnętrznym. Na niej robi się SEO.
Które kombinacje filtrów zamienić w podkategorie?
Nie zgaduj. Wybieraj według popytu:
- Zbierz kombinacje, których klienci faktycznie szukają. W Google Search Console, w raporcie skuteczności dla strony kategorii, zobacz zapytania, z których przychodzi ruch. Frazy typu „buty biegowe damskie” podpowiadają podkategorię, której jeszcze nie masz.
- Sprawdź popyt w narzędziu do słów kluczowych. Wolumen wyszukiwań znajdziesz w Ahrefs lub Planerze słów kluczowych Google. Kombinacja bez wyszukiwań nie jest podkategorią, tylko filtrem.
- Policz produkty. Podkategoria z jednym lub dwoma produktami jest cienka. Jeśli wynik filtra jest pusty, nie rób z niego strony.
- Sprawdź SERP. Jeśli Google pokazuje na tę frazę listingi sklepów, podkategoria ma sens. Jeśli pokazuje poradniki, zobacz wpis o tym, co stworzyć pod frazę: kategorię, produkt czy wpis blogowy.
- Zadbaj, żeby nie kanibalizowała kategorii nadrzędnej. Każda podkategoria potrzebuje innego tytułu, H1 i opisu niż strona, z której wychodzi. Jak rozpoznać takie konflikty, opisuję we wpisie o tym, dlaczego pozycje stoją w miejscu.
Masz setki kategorii i nie wiesz, od których podkategorii zacząć? Napisz do mnie, przygotuję listę kombinacji według popytu.
- 1Popyt w Search ConsoleZapytania z raportu skuteczności strony kategorii, np. „buty biegowe damskie”.
- 2Wolumen w narzędziuAhrefs lub Planer słów kluczowych. Kombinacja bez wyszukiwań to filtr, nie podkategoria.
- 3Liczba produktówPodkategoria z jednym lub dwoma produktami jest cienka. Pustego wyniku filtra nie zamieniaj w stronę.
- 4SERPListingi sklepów w wynikach: podkategoria ma sens. Poradniki: zobacz, co stworzyć pod frazę.
- 5Brak kanibalizacjiInny tytuł, H1 i opis niż strona nadrzędna, z której podkategoria wychodzi.
Jak zablokować indeksację filtrów i co każda metoda naprawdę robi?
Google opisuje kilka sposobów i żaden nie jest uniwersalny. Warto znać ich ograniczenia, zanim wybierzesz.
Plik robots.txt. To pierwsza metoda opisana w dokumentacji o nawigacji fasetowej: jeśli nie potrzebujesz filtrów w wynikach, zablokuj ich crawlowanie i zostaw robotowi strony produktów oraz stronę listingu bez filtrów. Dokumentacja podaje wzór reguł dla parametrów:
user-agent: Googlebot
disallow: /*?*products=
disallow: /*?*color=
disallow: /*?*size=
allow: /*?products=all$
W sklepie z przykładu wyżej reguły dotyczyłyby parametrów kolor=, rozmiar= i marka=. Linia allow zostawia robotowi listing bez filtrów. Tak samo wyłącz z blokady podkategorie, jeśli w Twojej platformie działają na parametrach. Ograniczenie: robots.txt zarządza ruchem robota, nie indeksem, więc nie usuwa adresów z wyników (szczegóły w FAQ niżej).
Znacznik noindex. To właściwa metoda, gdy adres ma zniknąć z wyników. Ograniczenie jest odwrotne: robot musi wejść na stronę, żeby zobaczyć regułę, więc strona nie może być jednocześnie zablokowana w robots.txt. Zależnie od tego, jak ważna jest strona, ponowna wizyta robota może potrwać nawet miesiące (Block Search indexing with noindex). Noindex nie oszczędza więc crawlowania tak jak robots.txt.
Fragment adresu (#). Google zwykle nie obsługuje fragmentów adresu przy crawlowaniu i indeksowaniu, więc filtrowanie zmieniające tylko część po # nie wpływa na crawlowanie. To dobra metoda, jeśli platforma na to pozwala (dokumentacja nawigacji fasetowej).
Canonical i nofollow. Dokumentacja nazywa je mniej skutecznymi na dłuższą metę niż robots.txt i fragment adresu. Atrybut rel="nofollow" działa tylko wtedy, gdy każdy link do danego adresu go ma.
Jak połączyć to w praktyce? To mój wniosek z dokumentacji, nie gotowa recepta Google. Gdy filtry nie są jeszcze w indeksie, zablokuj je w robots.txt. Gdy już w nim są, najpierw dodaj noindex (bez blokady w robots.txt), poczekaj, aż znikną z wyników, i dopiero wtedy ewentualnie zablokuj crawlowanie. Pamiętaj, że po blokadzie robot nie zobaczy już noindex, więc adres, do którego prowadzą linki z innych stron, może wrócić do wyników bez opisu. Jeśli takie linki istnieją, zostaw sam noindex.
- Plik robots.txtZarządza ruchem robota, nie indeksem: nie usuwa adresów z wyników.
- Znacznik noindexWłaściwa metoda, gdy adres ma zniknąć z wyników. Strona nie może być zablokowana w robots.txt. Ponowna wizyta robota może potrwać nawet miesiące.
- Fragment adresu (#)Google zwykle nie obsługuje fragmentów przy crawlowaniu i indeksowaniu. Dobra metoda, jeśli platforma na to pozwala.
- Canonical i nofollowDokumentacja nazywa je mniej skutecznymi na dłuższą metę. Nofollow działa tylko wtedy, gdy każdy link do adresu go ma.
Jak sprawdzić, w jakim stanie są teraz filtry w Twoim sklepie?
W Search Console otwórz raport Indeksowanie stron (Page indexing) i przejrzyj adresy z parametrami z listy pozycji niezaindeksowanych, a także te zaindeksowane. Szukasz parametrów filtrów i sortowania, np. kolor=, rozmiar=, sort= (nazwy zależą od platformy). Lista przykładów w raporcie ma najwyżej 1000 wierszy, więc w dużym sklepie to próbka, nie pełny spis. Filtry wśród zaindeksowanych albo ze statusem „Indexed, though blocked by robots.txt” (zaindeksowana mimo blokady w robots.txt) to problem do uporządkowania. Status duplikatu bez wskazanej strony kanonicznej Google uznaje za działanie zgodne z zamierzeniem, ale setki takich adresów z parametrami pokazują, że robot crawluje filtry. Pomoc Search Console zaznacza, że duża liczba duplikatów powstaje często przez filtrowanie i sortowanie kolekcji parametrami (Page indexing report).
Kto może to zrobić za Ciebie?
Jeśli nie masz czasu ani programisty do przeglądu platformy, mogę przeanalizować nawigację sklepu, wskazać które filtry zablokować, a które kombinacje zamienić w podkategorie według popytu. Jestem konsultantem SEO i AI, w SEO od 2011 roku, a sklepami zajmuję się na co dzień (pozycjonowanie sklepów internetowych; przy dużym sklepie zacznij od audytu SEO). Zrobię to szybko, dobrze i niedrogo. Pierwsze 30 minut rozmowy jest bezpłatne (umów konsultację).
Źródła (dokumentacja Google, dostęp 07.10.2026)
- https://developers.google.com/crawling/docs/faceted-navigation
- https://developers.google.com/search/docs/crawling-indexing/robots/intro
- https://developers.google.com/search/docs/crawling-indexing/block-indexing
- https://developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls
- https://support.google.com/webmasters/answer/7440203
Komentarz eksperta
Najczęstszy problem, który napotykam w sklepach, to setki dynamicznych adresów generowanych przez filtry i sortowanie, które zbyt często trafiają do indeksu jako osobne, niemal identyczne podstrony. Drugi to mylenie Disallow z noindex: ktoś blokuje stronę w robots.txt, licząc, że usunie ją z wyników, a tymczasem strona może wisieć w Google bez opisu.
Paweł Wołoszyn, Konsultant SEO i AI Najczęściej zadawane pytania (FAQ)
Czy filtr, na który jest duży popyt, mogę zaindeksować?
Tak, ale jako podkategorię, a nie adres z parametrem. Jeśli mimo to chcesz indeksować adresy filtrów, Google zaleca separator parametrów &, a przy filtrach zapisanych w ścieżce adresu stałą kolejność i brak powtórzonych filtrów. Kombinacja bez wyników powinna zwracać kod 404, a nie pustą stronę (Managing crawling of faceted navigation URLs).
Czy sam canonical z filtra na kategorię wystarczy?
Nie, jeśli celem jest oszczędzanie crawlowania. Canonical z filtra na kategorię może jedynie z czasem zmniejszyć crawlowanie niekanonicznych adresów (dokumentacja nawigacji fasetowej), bo to dla Google silny sygnał, a nie polecenie. Kanonicznych adresów nie wskazuje się też przez noindex, bo to całkowicie usuwa stronę z wyników (How to specify a canonical URL).
Czy blokada w robots.txt usunie filtry z Google?
Nie. Robots.txt blokuje crawlowanie, a nie indeksowanie: zablokowany adres może nadal pojawić się w wynikach bez opisu, jeśli prowadzą do niego linki z innych stron (Introduction to robots.txt). Do usuwania z wyników służy noindex. Ponowną wizytę robota na stronie z noindex możesz przyspieszyć, zgłaszając adres w narzędziu do sprawdzania adresów URL w Search Console (Block Search indexing with noindex).